上一篇是 Day 3|Harness 的硬约束:静态契约与生命周期 Hook。了解了静态契约和 Hook 的原理后,本篇是练习篇——我们动手改造一个真实项目。
本篇是 L3 的练习篇。后续导航:
| Day | 类型 | 主题 |
|---|---|---|
| Day 5 | 骨干 | 工具即界面:三种扩展路径 |
| Day 6 | 练习 | 给你的 Agent 装一个新工具 |
| Day 7 | 骨干 | 元架构:Everything is a Plugin |
| Day 8 | 骨干 | 记忆、轨迹与可观测性 |
| Day 9 | 练习 | 毕业项目:搭建团队级 CI/CD 自动化 Harness |
| Day 10 | 阶段小结 | L3 毕业考核 + Harness 未来趋势 |
你有没有遇到过这种事
Day 3 我们拆解了 Harness 硬约束的两层机制:静态契约(AGENTS.md 定义权限边界)和 Hook 拦截(运行时审查每次工具调用)。至少知道 AGENTS.md 长什么样、权限弹窗为什么是表演式安全了。概念清楚,但落到你自己的项目里,问题马上冒出来——
你给 Claude Code 或 Codex 配了一份 AGENTS.md,心想这下 AI 该懂规矩了。结果呢:
随着项目迭代,AGENTS.md 的字数从几十行一路涨到了几百行,每次会话上下文被撑得满满当当,真正干活的空间反而没了。
- 写了很多"规范",但 AI 该乱来还是乱来,因为你写的是建议,不是约束。
- 某个版本更新后,AI 突然开始无视你写好的规则,你不知道是 prompt 失效了还是模型变了。
- 你想检查 AI 有没有按规范写代码,只能人工逐行 review,根本没时间。
这些问题的根因只有一个:你把 AGENTS.md 当成了百科全书,而不是目录。
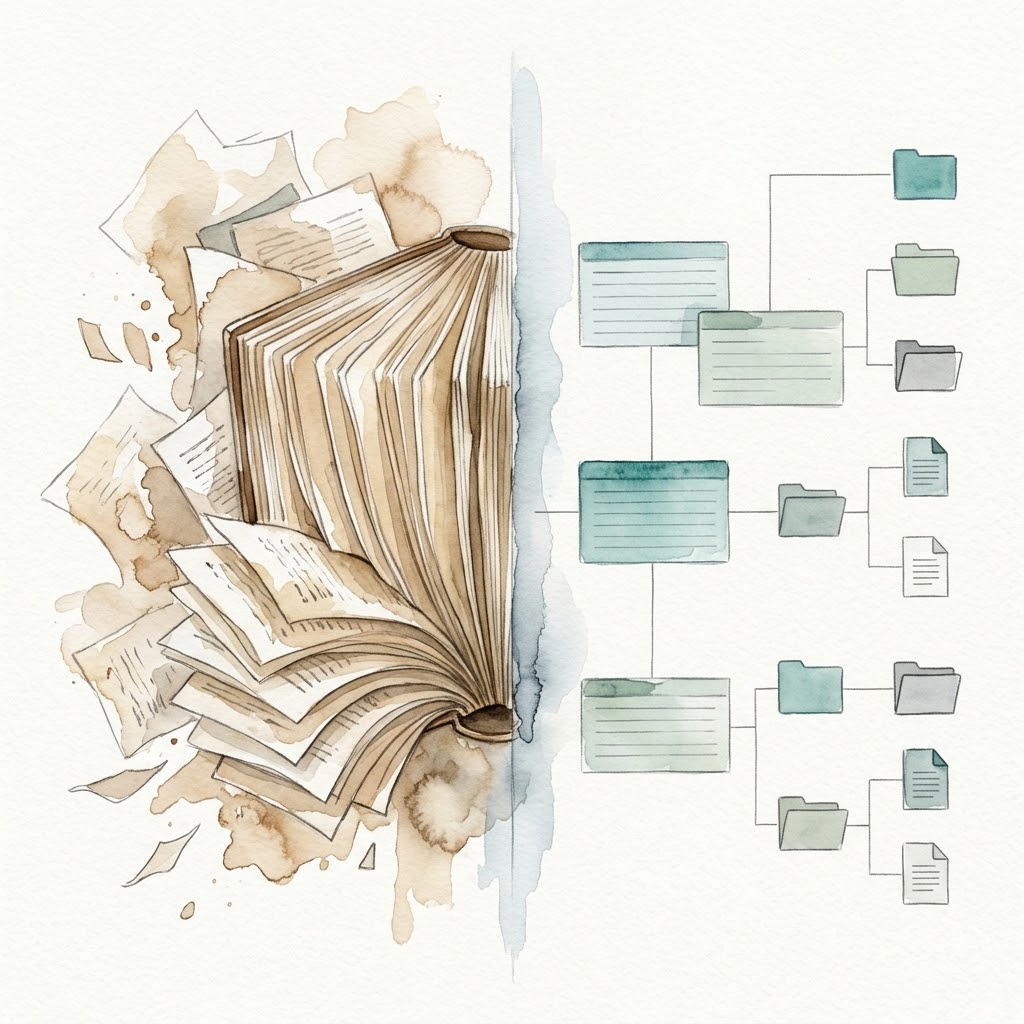
判断:AGENTS.md 应该是目录,不是手册
OpenAI 的 Harness Engineering 团队在打造百万行代码产品时,也踩过这个坑。他们最初的做法和大多数人一样:一份超大的 AGENTS.md,把架构决策、编码规范、产品背景全部塞进去[1]。结果呢?
“当什么都标为’重要’,就等于什么都不重要。”
模型面对几百行指令时,会退化为局部模式匹配——它不再理解整体目标,而是机械地匹配关键词。文件越大,腐烂越快,因为没人愿意维护一份没人完整读过的文档。
他们的解法只有一句话:把 AGENTS.md 当作目录,而非百科全书[1]。
具体做法是把 AGENTS.md 控制在 100 行以内,让它只做一件事:告诉 Agent 去哪里找信息。真正的细节放在 docs/ 目录下的独立文件里——架构文档、编码规范、测试策略各管一摊。这样 AGENTS.md 本身保持稳定,模型按需读取,上下文不会被无意义的信息淹没。
这和 Day 3 讲的"静态契约"一脉相承:契约的核心不是内容多,而是机器可读 + 低开销。
证据:一份坏 AGENTS.md 的四条死因
OpenAI 通过实战总结了四类典型的 AGENTS.md 失败模式,你可以直接拿来给自己的文件打分:
| 问题 | 表现 | 后果 |
|---|---|---|
| 太长 | 超过 100 行,涵盖范围从架构到配色 | 挤占任务上下文,模型重点失焦 |
| 无优先级 | 所有条目都标"重要" | 模型退化为关键词匹配,失去导航能力 |
| 无法校验 | 全是自然语言描述,没有机械检查手段 | 规则过时了没人知道,变成装饰品 |
| 单点存储 | 所有内容堆在一个文件 | 无法分权维护,一人离职文档即腐烂 |
这四条不是理论推测,是 OpenAI 团队在百万行代码项目上踩出来的真实教训[1]。
我自己也做过一次同构实验。tdd-pipeline 的阶段 skill 文件加起来 1617 行,我把操作步骤全部删掉,只保留原则、风险提示和反面例子,总行数降到 1360 行(-16%)。四轮盲测,三轮通过。最有意思的发现是:模型自己推导出了被删掉的步骤——旧版写着"Step 1 收集需求,Step 2 分类用户故事",精炼版只有"理解要建什么、为什么",模型的分析里自动出现了同样的推导链,但它自己组织的。
但第四轮盲测暴露了一个关键边界:审核触发器和阶段切换指针被删掉后,模型不知道该不该触发审核、该进哪个阶段。有些内容不是"模型能推导的领域逻辑",而是"流程协议",必须显式保留[2]。这次实验的完整记录在《以尺度尺,用方法改进方法》里。
读者今天要做的练习和我当时做的是同一场仗,只是规模不同:你精简的是一份 AGENTS.md,我精简的是五个阶段的 skill 文件。
我们的解决思路是对症下药:把"百科全书"拆成"目录 + 子文档",用机器可读格式替代部分自然语言描述,用 Hook 替代人工 review。
第一步:审计你的 AGENTS.md
先别急着改,拿出一份你自己的 AGENTS.md(或者项目里的 CLAUDE.md、.cursorrules,它们本质上是同一个东西),对照上面的表格打分数:
长度检查:当前多少行?
  □ < 50 行(优秀)
  □ 50-100 行(可接受)
  □ 100-200 行(需要精简)
  □ > 200 行(必须重构)

优先级检查:有没有分级(P0/P1/P2 或 must/should/can)?
  □ 有
  □ 没有

校验性检查:规则能否被 lint/CI 机械检查?
  □ 大部分可以
  □ 部分可以
  □ 全部是自然语言,无法自动检查

结构检查:是否引用了 docs/ 子目录或其他文件?
  □ 已有子文档结构
  □ 全部堆在一个文件里
如果三项以上亮红灯,就说明你的 AGENTS.md 需要一次结构性改造。
第二步:重写为目录式结构
改造的核心原则是:AGENTS.md 只保留导航,细节下沉到子文档。
下面是一份改造后的示例结构:
project-root/
├── AGENTS.md              # 目录层:< 100 行,只含导航和关键规则
├── docs/
│   ├── architecture.md    # 架构文档
│   ├── conventions.md     # 编码规范
│   ├── testing.md         # 测试策略
│   └── standards/         # 领域标准(可选)
├── feature_list.json      # 功能清单(机器可读的范围约束)
└── hooks/
    └── post_tool_use.sh   # Hook 脚本
AGENTS.md 示例(精简版):
# My Project

一句话描述项目是什么。

## 必读(启动时必须加载)
- [项目概述](./docs/architecture.md)
- [编码规范](./docs/conventions.md)
- [当前功能清单](./feature_list.json) ← 机器可读,圈定范围

## 按需读取
- [测试策略](./docs/testing.md)
- [错误处理规范](./docs/standards/error-handling.md)

## 硬约束(不可协商)
- 禁止修改 `docs/architecture.md` 中的架构图
- 每次提交前必须跑 `npm test`,失败不得 commit
- 超出 feature_list.json 范围的功能需先更新清单再开发

## 本次任务
读取 feature_list.json,找出 priority=1 且 status=not_started 的条目,开始实现。
这份 AGENTS.md 只有约 25 行,但通过引用指向了完整的知识库。模型每次启动只加载这 25 行,需要详情时再按需读取子文档。上下文节省了多少,你自己算。
第三步:加入 feature_list.json 圈定范围
walkinglabs 的课程项目 learn-harness-engineering[3] 把 Harness 拆成 instructions、tools、environment、state、feedback 五个子系统,并论证功能清单是 Harness 的原语:范围约束必须写成机器可读的契约,而不是留在对话里的口头约定——一次只做一个功能,不许贪多,不许烂尾三个。
光有 AGENTS.md 还不够,你还需要一份机器可读的功能清单,让 Agent 明确知道"这次只能做什么"。
feature_list.json 是该课程项目 Resource Library(资源库)里的四个起始模板之一(另外三个是 AGENTS.md、init.sh、claude-progress.md)。它起作用的方式是:AGENTS.md 里的指令要求 Agent 启动时读它,Agent 用 read 工具把清单加载进上下文,然后按清单执行。
清单自己不会检查自己。它真正起作用要靠检查程序配合:清单记录"做什么、怎么算做完",检查程序核对"证据是不是真的"。walkinglabs 就配套了一个校验脚本 feature-list-validator.ts[4],读任何项目的 feature_list.json,校验 schema,抓出"标了 passing 却没有验证证据"的条目。这类检查功能 Codex、Claude Code、Pi 默认都没有,但都能自行实现——Pi 写扩展,Claude Code 配 Hook,validator 脚本在任何能跑命令的地方都能跑。
{
  "features": [
    {
      "id": "F001",
      "priority": 1,
      "area": "auth",
      "title": "用户登录接口",
      "user_visible_behavior": "输入邮箱和密码后点击登录,成功跳转首页,失败显示错误提示",
      "status": "passing",
      "verification": "curl -X POST /api/login -d '{\"email\":\"[email protected]\",\"password\":\"test123\"}'",
      "evidence": "tests/auth/test_login.py::test_login_success PASSED"
    },
    {
      "id": "F002",
      "priority": 1,
      "area": "auth",
      "title": "密码重置功能",
      "user_visible_behavior": "点击忘记密码,输入邮箱接收重置链接,点击链接后可设置新密码",
      "status": "in_progress",
      "verification": "curl -X POST /api/forgot-password -d '{\"email\":\"[email protected]\"}'",
      "evidence": ""
    },
    {
      "id": "F003",
      "priority": 2,
      "area": "search",
      "title": "全文搜索",
      "user_visible_behavior": "输入关键词后展示相关结果列表,支持分页",
      "status": "not_started",
      "verification": "curl 'http://localhost:3000/api/search?q=test'",
      "evidence": ""
    }
  ]
}
注意几个设计要点:
- 每次只有一个
in_progress:防止 Agent 贪多,一次只做一件事。 verification是机器可执行的命令:不是描述,是可运行的脚本或 curl 请求。evidence由 Agent 填写:验证通过后将测试结果填入,形成可追溯的证据链。status只有四种状态:not_started、in_progress、blocked、passing,不允许模糊状态。
这份 JSON 就是 Agent 的"任务边界"。用这份清单就能拦住 overreach(贪多)和 under-finish(烂尾)两种常见行为病的大部分场景。
第四步:加一个 Post-Tool-Use 拦截 Hook
前面三步解决了"告诉 Agent 做什么"的问题。但这一步要解决的是:Agent 做完了,怎么确保它做对了?
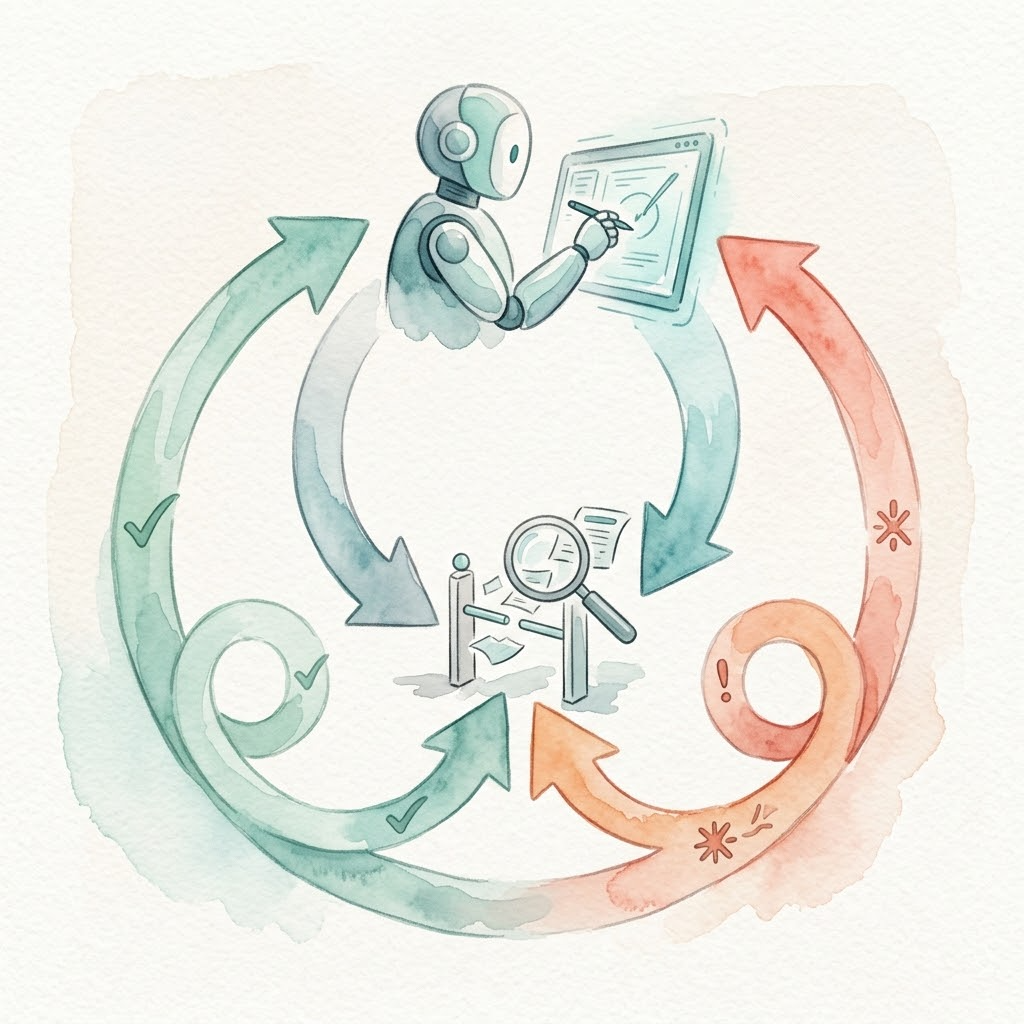
答案是 Post-Tool-Use Hook——工具执行完后自动触发检查,失败了就把报错信息回灌给模型,逼它自己修正。这就是 Back-Pressure 机制。
以 Python 项目为例,假设我们要在每次文件写入后自动跑 Linter。用 Pi 写一个扩展(TypeScript):
~/.pi/agent/extensions/lint-check.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.on("tool_result", async (event, _ctx) => {
    // 只检查 write / edit 工具的结果
    if (event.toolName !== "write" && event.toolName !== "edit") return undefined;

    const filePath = event.input?.path as string | undefined;
    if (!filePath?.endsWith(".py")) return undefined;

    console.error(`[Lint-check] Running ruff on ${filePath}`);

    const { stdout, code } = await pi.exec("ruff", ["check", filePath]);
    if (code !== 0) {
      // 把错误附加到工具结果上并标记为失败,回灌给模型,触发 Back-Pressure
      return {
        content: [
          ...event.content,
          { type: "text", text: `Ruff 报错:\n${stdout}\n请修复后重试` },
        ],
        isError: true,
      };
    }

    return undefined; // 通过,保持原结果
  });
}
把这个文件放到 ~/.pi/agent/extensions/ 目录,Pi 启动时自动加载。不需要在配置文件里额外注册——这就是 Pi 的约定。
Claude Code 的等效做法则完全不同:它把 Hook 写成独立的 Shell 脚本,通过 stdin/stdout 接收 JSON 事件[5],在项目根目录的 .claude/settings.json 里声明:
{
  "hooks": {
    "PostToolUse": [{ "matcher": "Write|Edit", "hook": "./hooks/post_tool_use.sh" }]
  }
}
两者逻辑一致,但实现路径不同:Pi 让你直接写 TypeScript,Hook 和业务代码在同一语言栈里;Claude Code 则要求你写 Shell,通过 JSON 序列化与 Agent 进程通信。选择哪种取决于你日常用的工具——关键是理解机制,而不是工具的语法。
第五步:对比验证
改造完成后的验证方式很简单——用同一个任务,分别在旧版和新版环境下跑一遍,对比结果。
举个例子:
任务:给项目添加一个用户注册接口。
旧版 AGENTS.md(300 行,百科全书式):
- Agent 读了 300 行后,上下文已经被占用了 60%
- 它同时打开了架构文档、编码规范、测试策略,信息过载
- 写出的代码缺少错误处理,因为没有明确的强制规则
- 你不得不人工 review 才发现漏了东西
新版 AGENTS.md(25 行 + feature_list.json + Hook):
- 启动时只加载 25 行,上下文充裕
- feature_list.json 明确告诉它"注册接口是 F004,priority=1"
- 写完代码后,Hook 自动触发 Linter,发现缺少类型注解,报错回灌
- 模型自行修复,再次触发 Hook,通过
- 整个过程中你没有说过一句话
这就是 Back-Pressure 的价值:把人的 review 工作转移到机器自动执行,你只需要在 Hook 里配置检查规则,剩下的交给 loop。
可选进阶:给你的项目搭一套可复用的契约模板
今天你改了一份 AGENTS.md、加了一个 Hook。下一步是把这套模式固化下来,方便下次换项目时快速复用。
具体做法:
- 建一个模板目录:把今天改造后的目录结构复制成项目模板——
AGENTS.md(目录层)、docs/(子文档)、feature_list.json(范围约束)、hooks/(Hook 脚本)。 - 把今天写的 Hook 参数化:把 ruff 换成你项目实际用的工具,matcher 改成你实际拦截的工具名,把路径写到环境变量或配置文件里。
- 写一份 README:说明这个模板给谁用、怎么装、每个文件负责什么。下次开新项目直接 copy,十五分钟配好。
这样做的好处是:你今天亲手踩过的坑——文件越写越长、权限弹窗是表演式安全、模型不守规矩——下次开新项目的時候,你不会重蹈覆辙。
今日收获
今天我们一起完成了五件事:
- 用 OpenAI 的四条失败标准诊断了 AGENTS.md 的常见问题——太长、无优先级、无法校验、单点存储。
- 掌握了目录式重构方法:AGENTS.md 控制在 100 行以内,只做导航,详情下沉到
docs/子文档。 - 学会了用
feature_list.json做机器可读的范围约束,拦截 overreach(贪多)和 under-finish(烂尾)两种常见行为病。 - 亲手实现了一个 Post-Tool-Use Hook,用 Back-Pressure 机制让 Linter 错误自动回灌给模型。
- 通过新旧环境对比,直观感受了"硬约束"和"软建议"在 Agent 行为上的差异。
记住一句话:契约管该不该做,Hook 管做得对不对。两者配合,才是完整的硬约束体系。
Day 5 我们进入加法阶段——当你的 Harness 已经够约束了,接下来要考虑的是怎么让它能干更多活。三种扩展路径(MCP Server、Pi 扩展、DSH 插件)各有取舍,下一篇逐一拆解。
参考资料
- OpenAI: Harness engineering——「把 AGENTS.md 当作目录而非百科全书」方案的原始出处;文中记录了百万行代码项目踩坑后拆出 docs/ 子文档的具体做法
- 以尺度尺,用方法改进方法:tdd-pipeline V0.7 精炼实验·结果章节(Round C 流程协议发现)
- walkinglabs/learn-harness-engineering:课程项目主页——GitHub 开源组织 walkinglabs 的 Harness Engineering 课程;五子系统框架见 Lecture 02,功能清单原语论证见 Lecture 08
- feature_list.json 模板原文(Resource Library);机械校验脚本见 feature-list-validator.ts
- Claude Code 文档:Hooks reference — PostToolUse 节