从 Anthropic 的对齐研究到一个 Prompt 设计思路
TL;DR: Anthropic 的对齐研究表明,教模型"为什么"比教"做什么"更有效——误对齐率从 22% 降到 3%。本文拆解四组实验,提炼出三个可迁移的 prompt 设计教训。 ...
TL;DR: Anthropic 的对齐研究表明,教模型"为什么"比教"做什么"更有效——误对齐率从 22% 降到 3%。本文拆解四组实验,提炼出三个可迁移的 prompt 设计教训。 ...
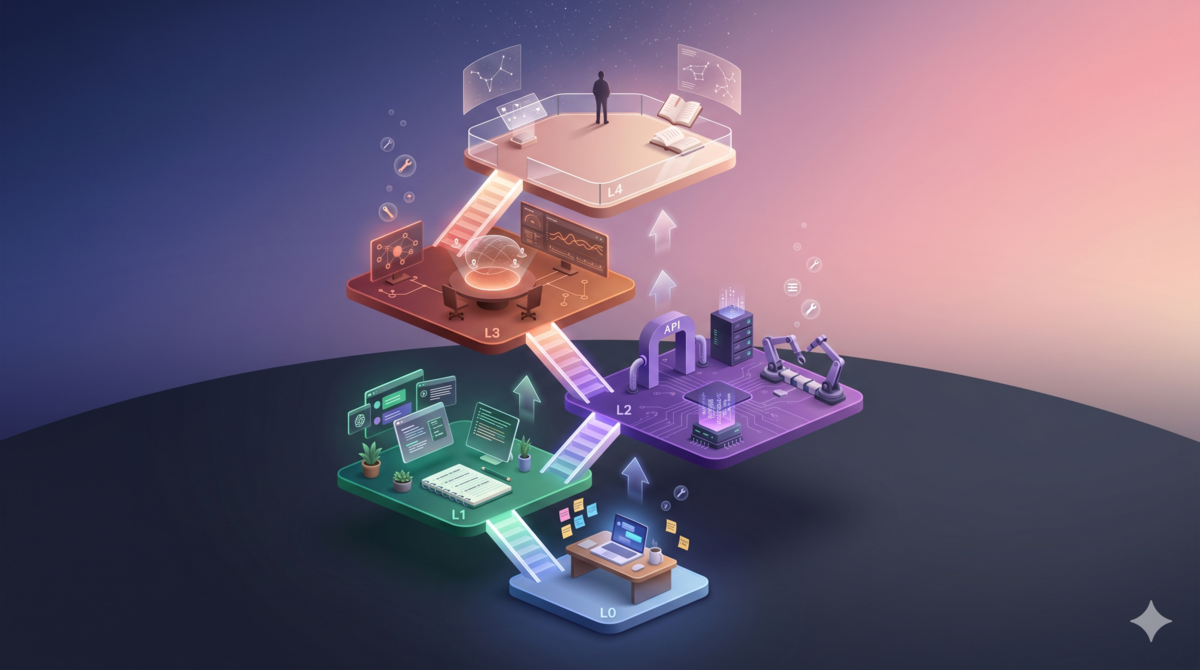
TL;DR: 一个使用 AI 的人会经历怎样的成长?这篇文章把从"第一次打开对话框"到"以 AI 的方式思考"的旅程分为五个阶段——初触者、使用者、工程师、架构师、原住民。每个阶段的本质不是学会更多工具,而是思维方式发生一次跃迁:从被动接受输出,到主动设计输入,再到编排多 Agent 协作,最终重塑自己的认知框架。文末链接到交互式路径图,可以展开探索每个阶段的完整内容。 ...
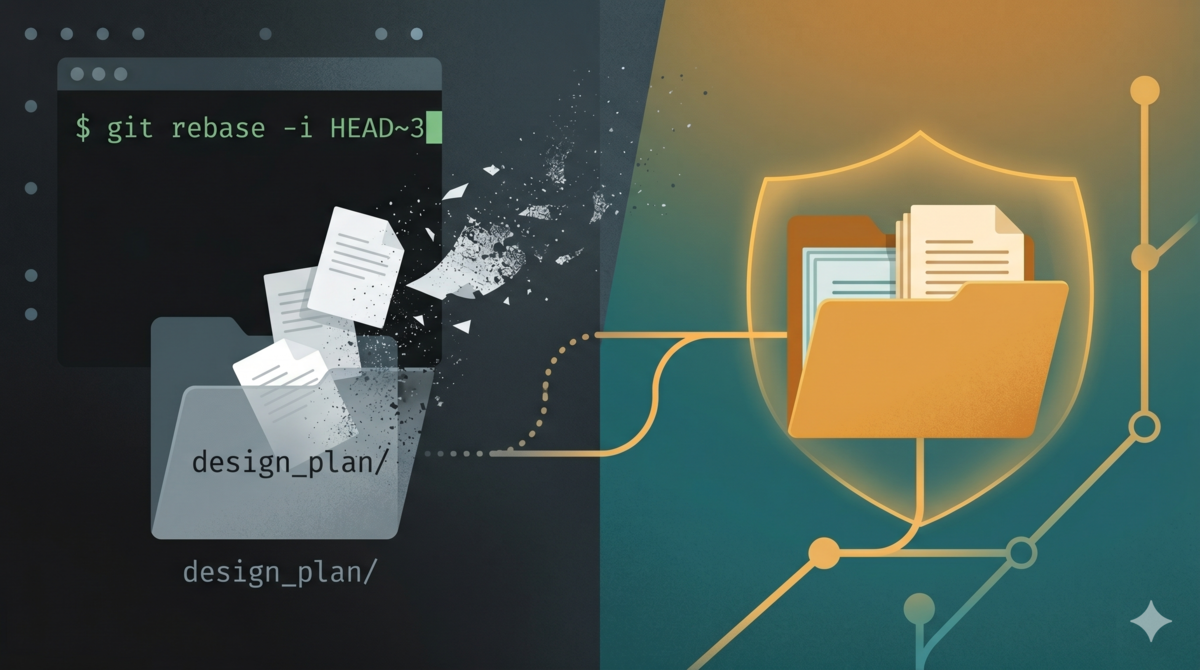
TL;DR: git rebase / checkout 会静默删除 .gitignore 中的未追踪文件,且无法恢复;git stash -u 不会 stash git-ignored 的文件。解决方案是用 git worktree 创建 local-assets 分支,把设计文档放在被 git 追踪的安全空间里。三条命令搞定日常:dp-save.sh 保存、--prune 清理、--restore 恢复。多个项目实测引入后文档丢失归零。完整脚本见 alexwwang/design-doc-worktree。 ...
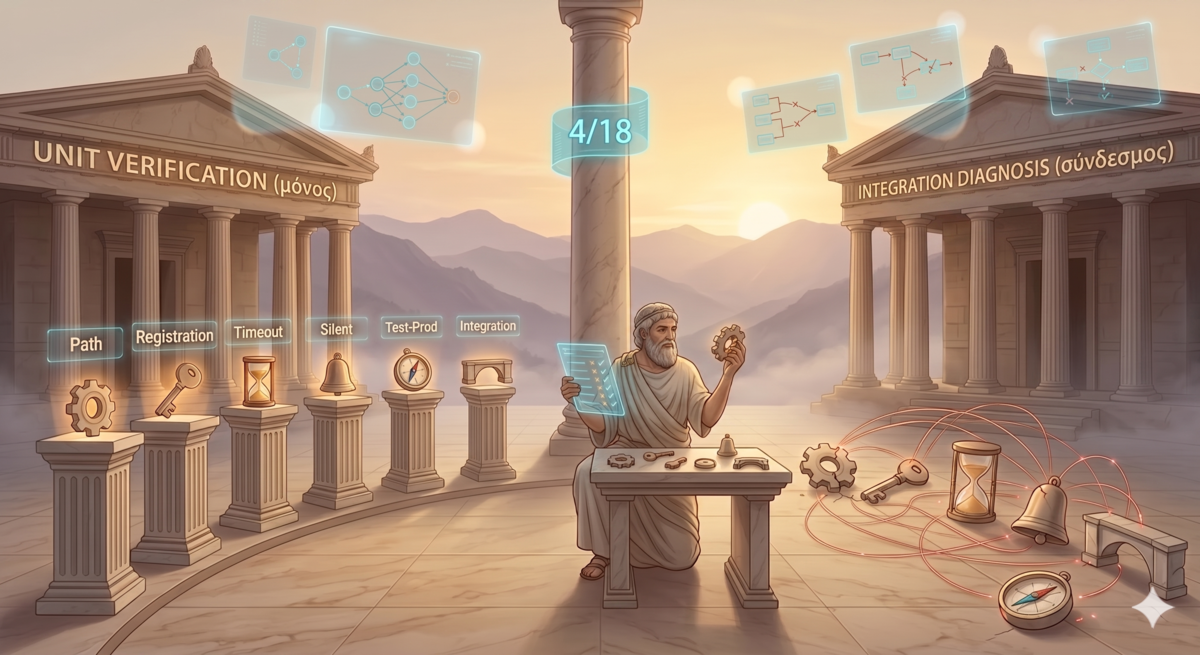
TL;DR: Aristotle v1.1 发布前发现 18 个 bug,单元测试只拦住 4 个(22%)。剩下 14 个都在集成层——组件接线、配置传递、进程启动的交叉点。对它们做 root cause analysis 后归纳出六种模式:路径/环境不一致(5 个)、注册遗漏(3 个)、启动阻塞(2 个)、静默失败(2 个)、测试-生产路径差异(2 个)、集成拼接错误(4 个)。根因不是问题变难了,是 AI 绕过了手写代码时靠经验建立的防线——实现和审查的节奏脱钩、代码外观误导了质量判断、集成环节从显式动作变成了隐式假设。文末附八维度集成检查清单和 16 种 bug 类型的路线图。 ...
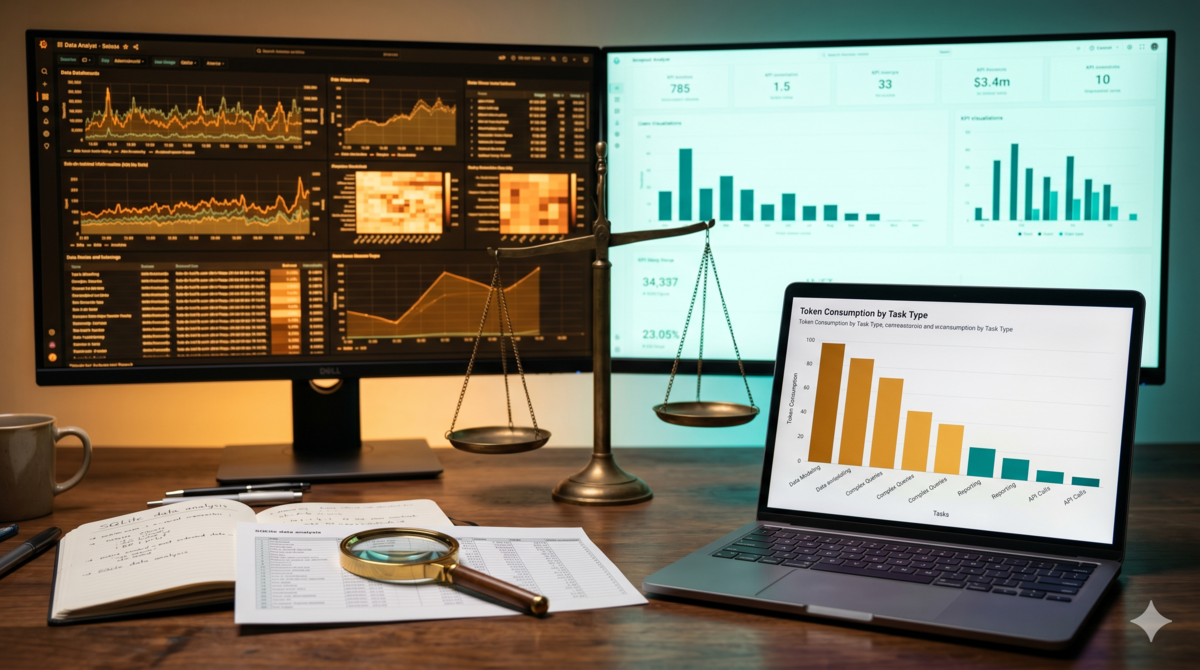
TL;DR: 从 OMO 切换到 SLIM 跑了 13 天,每消息平均 Token 数降了 3.7%,几乎持平。按任务类型拆开后发现:coding 持平,写作贵 61%,review 省 53%,debug 贵 121%(样本不足不可靠)。Aristotle 省 68%,但主因是架构重写不是插件差异。「省钱」不是全局事实,是局部现象。真正的差异在体验和架构选择上,不在 Token 数。 ...
TL;DR: 追问协议的最后一道防线是独立确认——用一个没有确认偏差的视角,对整个假说系统做可证伪性检验找反例。本文还讲了追问协议的来路(从 18 个 bug 的实践到写文章时发现的漏洞),以及未来自反性的计划。 ...
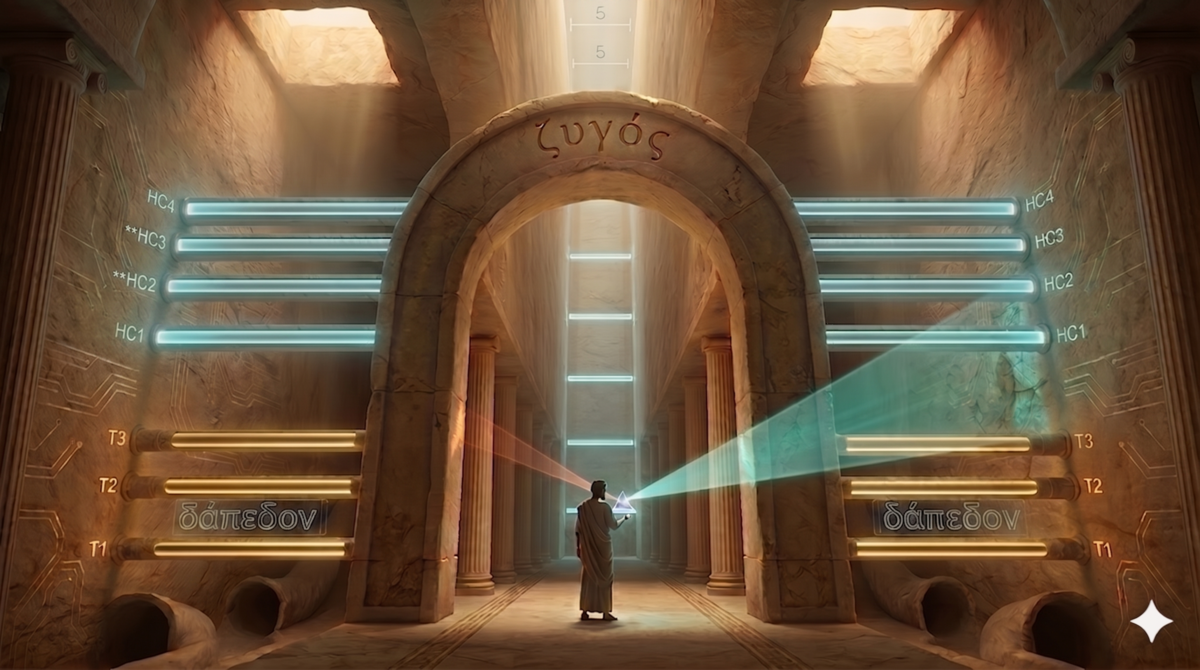
TL;DR: 追问协议用七个条件给 AI 的 5-Why 过程设规矩:T1–T3 是地板(不满足不许停),HC1–HC4 是护栏(防止过程失控)。其中 T2 的预防性反事实检验是最关键的设计——预防性 framing 迫使追问走深,同时反事实提问专门构造否定情境来对冲确认偏差。 ...
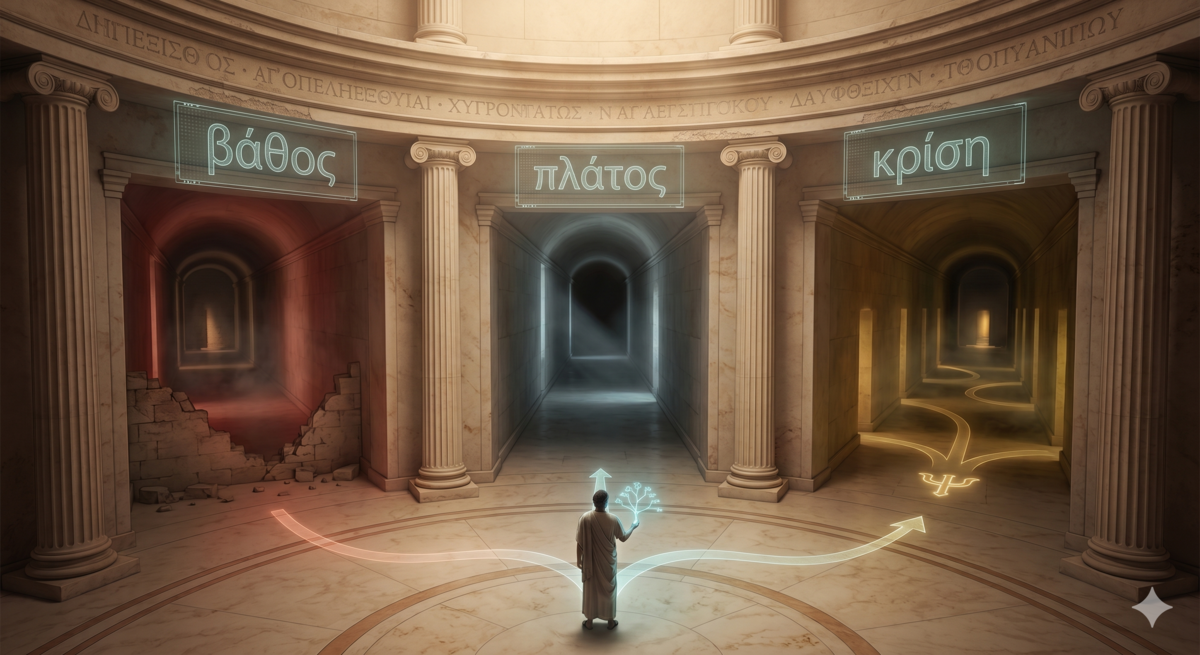
TL;DR: AI 用 5-Why 有三个问题:浅尝辄止(深度不够)、单线追踪(广度不够)、确认偏差(推理偏误)。三个问题独立但往往一起出现——浅层结论形成锚定后,会同时压缩探索空间和引导证据偏好。本文用一个四轮归因全部失败的真实案例,拆解每个问题的具体表现。 ...
一、引子:永远修不完的 bug 前几天,以完全实现 GEAR 协议为目标的 Aristotle 项目[1],终于成功验证了所有核心技术线路,代码也完成了第三次重构,实现了基本功能,并完善了测试。在准备把开发分支合并到 main 上线前,我做了一轮手工测试,发现 SKILL.md 的指令没有被模型正确执行——拿到了 action 却不调用 task() 启动后台 subagent,反而去加载了 LEARN.md。从排查这个问题开始,更多的 bug 被陆续发现: ...
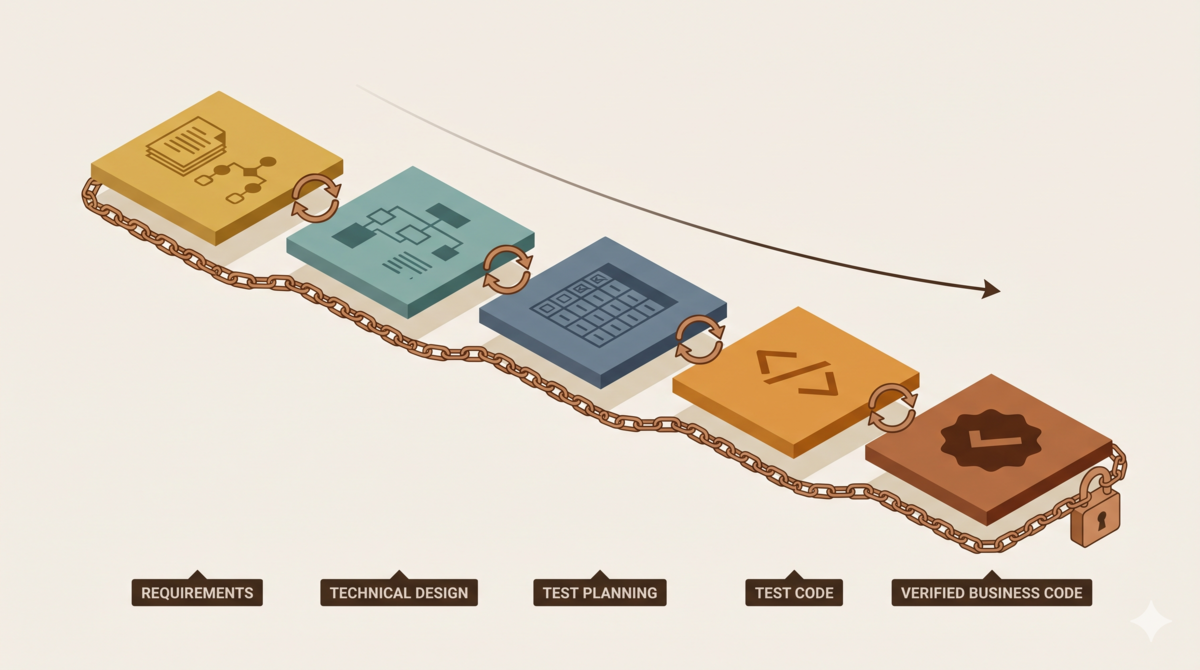
这是"用 TDD 驯服 AI 编码代理"系列的第 6 篇。前四篇分别讲了需求层、设计层、测试层和审核层,第 5 篇把审核层升级为程序正义。本篇把它们串成一条可落地的完整管线。 ...