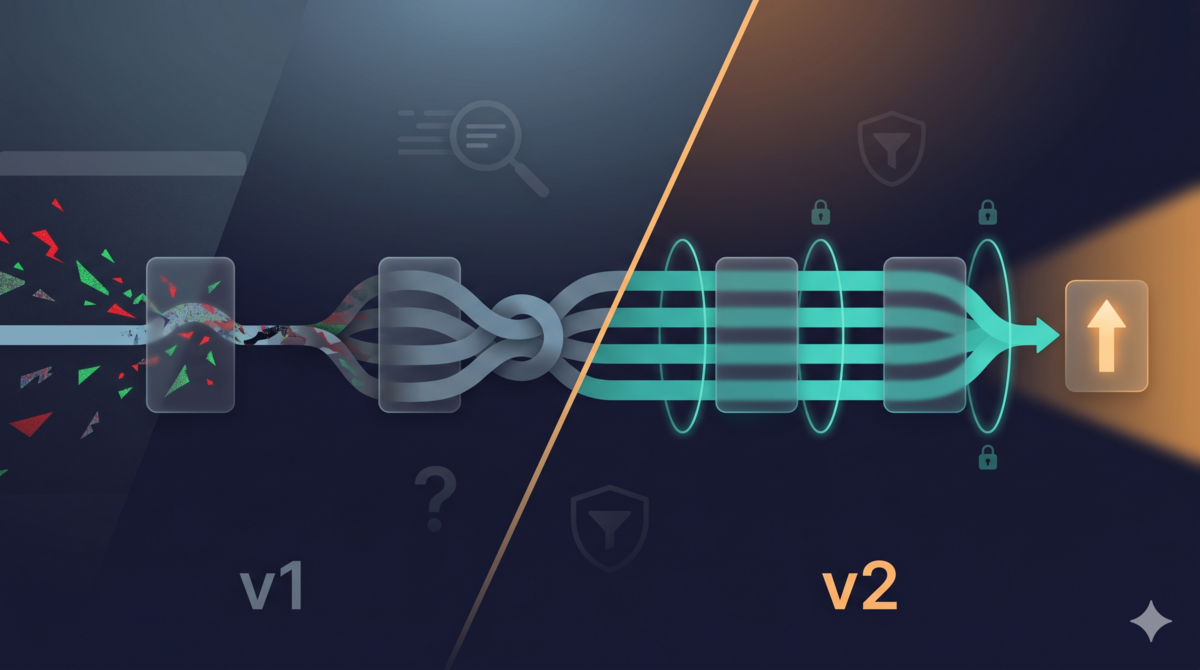
实验设计没毛病,LLM 为什么还是翻车了
系列:AI Agent 实验方法论(第二篇) 上一篇:如何用双盲实验验证 skill 改动的有效性 TL;DR: 双盲实验跑完第一轮,B 赢了 3/4 但没过"幅度筛选",结论是"证据不足"。排查发现 S1-A 的输出被终端颜色代码污染,scorer 在 ANSI 乱码上认认真真打了 8 个维度的分。修复执行上下文后重跑,B 变成 4/4 全胜。翻车的原因不是实验设计,是子 agent 的上下文构造没约束异常行为。 ...
系列:AI Agent 实验方法论(第二篇) 上一篇:如何用双盲实验验证 skill 改动的有效性 TL;DR: 双盲实验跑完第一轮,B 赢了 3/4 但没过"幅度筛选",结论是"证据不足"。排查发现 S1-A 的输出被终端颜色代码污染,scorer 在 ANSI 乱码上认认真真打了 8 个维度的分。修复执行上下文后重跑,B 变成 4/4 全胜。翻车的原因不是实验设计,是子 agent 的上下文构造没约束异常行为。 ...
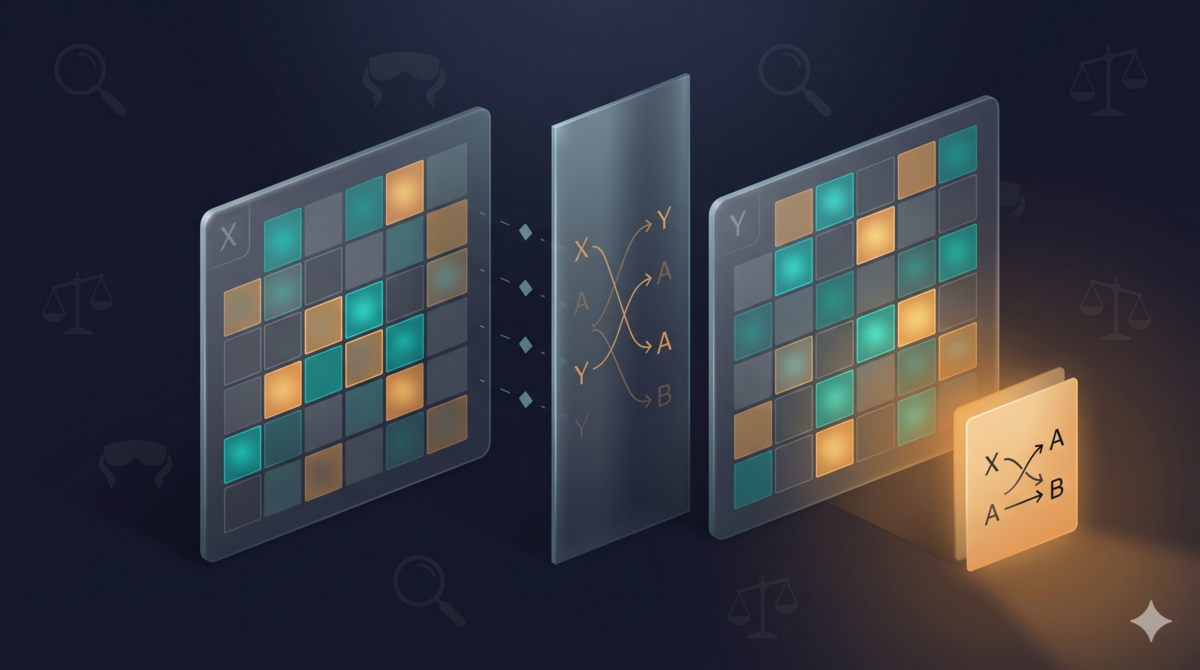
TL;DR: 改了 skill,怎么知道是真的变好了还是自我感觉良好?我跑了一个双盲实验:两个版本、四个场景、独立评审盲打分。评审看到 X=2.44、Y=2.41,说分不出来。揭盲后精简版 4/0 全胜。 ...
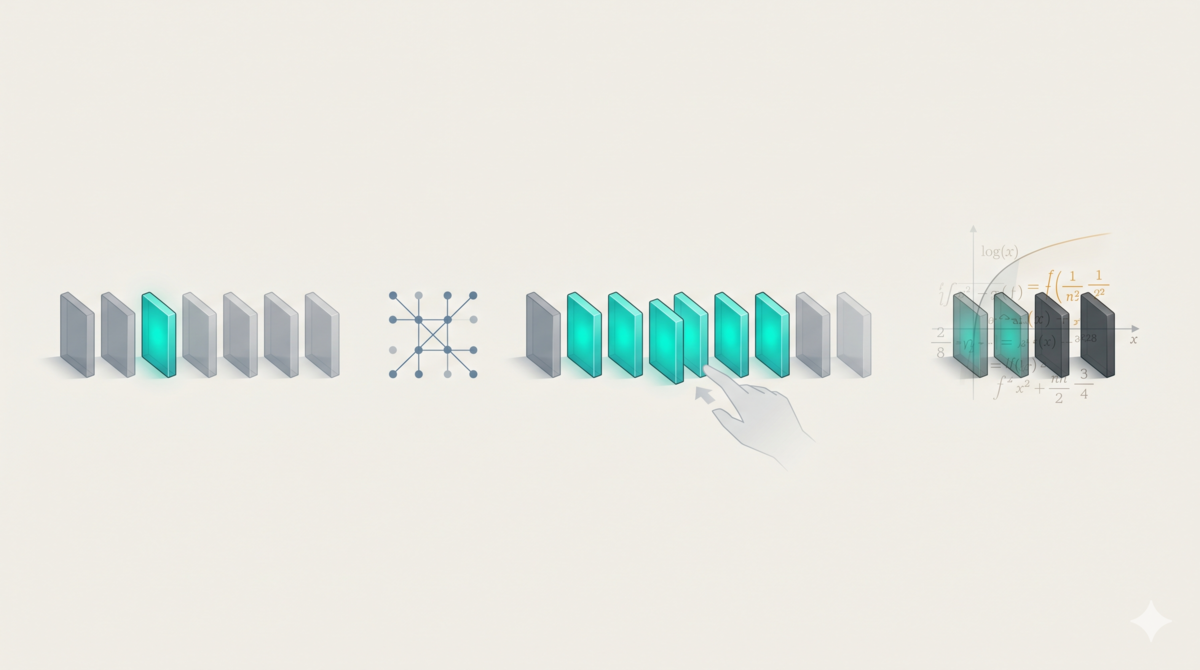
系列:用经典理论指导 Agent 实践(第三篇) 第一篇:双轮审查:召回和精确为什么不能兼得 · 第二篇:策略基因:借遗传算法思路精简审查 prompt TL;DR: 两组对照实验。代码审查维度从 8 个加到 11 个,已知问题的发现率从 1/6 升到 6/6。设计审查引入公理化设计维度,发现率同样从 1/6 升到 6/6。但加了数学公式的版本证明维度不是越多越好——计算过程挤掉了审查注意力,发现数掉 35%。做对照实验,用已知问题做参照,才知道哪个维度有效。 ...
系列:用经典理论指导 Agent 实践(第二篇) 上一篇:双轮审查:召回和精确为什么不能兼得 下一篇:维度实验:30多年前的奇书能搞定审查维度? TL;DR: 审查 prompt 从 317 行砍到 135 行(-58%),审查质量反升 29%。删掉的不是流程步骤,是模型自己能推导出来的冗余内容。留下的才是策略基因——不可替代的约束、反面例子和语气锁。 ...
系列:用经典理论指导 Agent 实践(第一篇) TL;DR: 设计审查的 agent 既要找得全又要找得准,一个 agent 难以两全。借鉴信息检索 15 年前的级联检索思路,拆成两个 agent——一个只管找全(Recall Pass),一个只管找准(Precision Pass)。设计方案的缺陷更早暴露,开发阶段返工的风险降低了。 ...
系列:破而后立的 TDD 流程迭代(第三篇) 第一篇:失之东隅,收之桑榆的实验 · 第二篇:以尺度尺,用方法改进方法 TL;DR: 阶段六已经在集成层做诊断——逐个 bug 追问根因。它不做的事是跨缺陷的模式扫描、组件缝隙检查、执行顺序分析。这些事归阶段七。小系统里阶段七多拦几个 bug;系统大了,同样是这三件事,产出变成建测试基础设施、硬化 CI 规则、驱动架构演进。阶段七不做架构决策,但它提供架构决策最稀缺的输入——基于证据的问题定位。 ...
系列:破而后立的 TDD 流程迭代(第二篇) 上一篇:失之东隅,收之桑榆的实验 · 下一篇:看不见的空白层——Phase 7 诞生 TL;DR: TDD Pipeline 自己教的是"给原则不给步骤",但自己却长成了步骤驱动的工具。把阶段一到阶段五的操作步骤删掉,只保留原则、风险提示和反面例子。模型自己推导出了被删掉的步骤,输出质量不降。原因:阶段一到阶段五是创作阶段,需要发散空间,去掉固定轨道反而更好。同样的策略用在阶段六上失败了——下一篇讲为什么。 ...
系列:破而后立的 TDD 流程迭代(第一篇) TL;DR: 把 TDD Pipeline 的阶段六(预发布测试)从"步骤驱动"精炼为"原则驱动",预设目标没达到——精炼版在单个 bug 的追问深度、证据链完整度上都比原版差。但对比两组输出发现了维度差异:精炼版在组件缝隙检查、跨 bug 模式扫描上比原版强。这些差异指向一个判断——阶段六不需要被精炼,而是缺了一个阶段六没有定义的任务,后来被定义为阶段七。 ...
TL;DR: 展示 Why Articulation 模板升级前后的对比,以及三条可迁移建议:给原则不给示例、关键步骤用强制语气、相信模型的自我组织能力。实验局限也已说明。 前两篇回顾 第一篇从 Anthropic 的对齐研究出发:教模型"为什么"比只教它"正确答案",误对齐率从 22% 降到 3%(约 7 倍),而且用 1/28 的数据量就能达到同等效果[1]。我把这个发现移植到 prompt 设计里,造出了 Why Articulation 模板——要求 AI 动手前先说清目的、风险和方案。 ...
TL;DR: 四变量 A/B 实验测试 Why Articulation 的结构、语气、位置和示例。正面示例反而有害——模型倾向模仿而非独立思考。开放式 prompt 方向性提升质量,同时节省 33% token。 系列:为什么让 AI 动手之前先说 why(第二篇) 上一篇:从 Anthropic 的对齐研究到一个 Prompt 设计思路 ...